


フィジカルAIでは今、グレートリセットが起きている。
AIを現場に入れるためのデータと、日本の現場力のゆくえ
第1回では、AIエージェントに仕事を任せるための「ハーネス」という仕組みと、任せる範囲、責任について考えました。第2回では、AIが画面の外へ、ロボットとして現実の世界へと出ていくフィジカルAIを入り口に、AIを現場に入れるための条件について話を進めます。
01 / Great Resetルールを組む世界から、データで解く世界へ
坂本:
画像の領域についても伺いたいのですが、マルチモーダルは、OpenAIやAnthropicの流れではそこまでテーマになっていない一方、Googleは比較的力を入れています。ABEJAさんとしては、マルチモーダルへの取り組みや実用について、どのようにお考えですか?
藤本:
もちろんやっております。マルチモーダルをどう考えるかは、非常に難しい問題です。機械学習は、データからその背後にある関係性を学ぶという意味で、一種の「逆問題を解く」ことだと捉えることができます。例えば、このインプットに対してこの正解を入れたら、中にこんなロジックがある、というのを自動で作っていくのが機械学習の仕組みです。画像認識もそうですし、今のLLMも、文章の続きを予測する学習などを通じて、言葉の関係やパターンを構築しています。
そのうえで、問題を解くときにマルチモーダルが本当に必要か、つまりインプットにそれだけの情報が真に必要かというと、結構ケースバイケースで、いらないケースも多いと思っています。最近の研究では、LLMを学習させたら、実は画像の概念を獲得していた、というものもあります。そう考えると、業務によっては、マルチモーダルまで行かなくても、意外と対応できるところも多いんじゃないかと思っているところがあります。
とはいえ、画像を使うのが本質的にいいのか、手っ取り早いだけなのかはケースバイケースなので、問題を解くために画像を使ったほうがいい場合は、ちゃんと使っています。問題に合わせてインプットを選んで、なるべく効率よく学習が進むように作っている、ということですかね。
坂本:
学習という観点とは別に、UXという観点でのマルチモーダルもあると思うんです。
藤本:
おっしゃる通りです。
坂本:
生成AIが爆発的に普及したのは、チャットになってUXが圧倒的に良くなったからだと思います。マルチモーダルになると、UXはさらに良くなると思うのですが、いかがですか?
藤本:
まさにその通りだと思っています。例えば、パワポを読んでもらったり、Excelを自分の代わりにやってもらったり、ということをAIにやってほしいとなったとき、人間って結局、目で見て動く生き物なので、人間のタスクをAIにやらせようと思ったら、どうしても目が必要になるんです。一方、人が普段使っている資料や画面をそのまま扱うには、図やレイアウトなど、テキストだけでは捉えにくい情報を理解する必要があります。そうした業務では、マルチモーダルが重要になります。人にとって使いやすい形でAIを活用するという意味でも、大きな役割があると思っています。
坂本:
では、フィジカルAIのお話に移りたいと思います。フィジカルAIという領域での取り組みを、簡単にご紹介いただけますか?
藤本:
ABEJAとしては、フィジカルAIにはもう結構取り組んでいて、2年ほど前からサービス提供をスタートしています。フィジカルAIの領域は面白くて、今、一度グレートリセットが起きている領域だと思っています。
僕も結構昔からロボットをやっているんですが、これまでは、ある種ルールを作って、画像認識などのロジックを元にピッキングしましょうとか、SLAMという手法で地図を作って自律移動しましょうとか、人間が内部のルールを実装して解くという世界でした。
坂本:
そこが今、変わってきているんですね。
藤本:
はい。まさに今、機械学習の波がロボットの動作にも来ていて、人間がすべての動作を一つ一つプログラムしなくても、データから動作を学習させることでロボットが対応できる作業が広がってきたという状況です。
例えばVLA※(ビジョン・ランゲージ・アクション)では、視覚情報や言語による指示をもとに、ロボットの動作を生成します。物をつかんで移動させるなど、さまざまな作業への応用が進んでいて、人間が正解データをたくさん与えれば、ロボットが自分で物をピッキングしたり、物をはめ込んだりしてくれる。もう少し先に行くと、ロボットが針の穴に糸を通したり、LANケーブルを差し込んだり、ドアを引いたり、洗濯物を畳むとか、ありとあらゆることができるようになってきます。これが、VLAの世界観です。
いろいろな取り組みがある中で、今、世界的に一番ネックになっている課題の一つはデータです。機械学習の時代から言われていることですが、データを持っている組織が強い。例えばGoogleは、検索の中で人のデータをどんどんためたことで精度が上がってきました。昔のインターネットではリンク集のようなものやルールベースでの検索やサイトを整理した仕組みがありましたが、それを大量のデータを使った機械学習で打破していった。その歴史と、今のロボットは似た話になっていると考えており、データを集め、質を確かめ、学習と現場での検証につなげることで、対応できる作業を増やしていくことで、自動で物事を解決できる、という状況になっていくと思います。
その中でABEJAは、ABEJA Platformを活用して、ロボットの動作や現場の状況に関するデータを収集・蓄積し、モデルの学習や改善に生かす取り組みを進めています。
※VLA(Vision-Language-Action):画像などの視覚情報と言語の指示から、ロボットの動作までを出力するAIモデル。
人間がロジックを理解していなくても、データをたくさん与えれば、問題が解けるようになってきた
02 / Into the Fieldもう、現場にロボットを入れてしまう
坂本:
ABEJAさんの深い話はなかなかお答えいただきにくいと思うので、世の中一般のフィジカルAIについて伺います。データの生成やシミュレーションでデータを増幅できるようになり、学習スピードも大きく上がっています。中国のロボットのオリンピックでは、1年前は確か20秒ぐらいかかっていた100mを、8秒台で走れるようになった。一方で、実用化の課題は、フィジカルAIだからこそ、AIエージェント以上にあるのではないかと思うのですが、どのようにお考えですか?
藤本:
まず、世界を正確にシミュレーションできる環境、例えばロボットが踊ったり歩いたりするのは、床と自分だけで済むので、シミュレーションデータをどんどんためていけば精度が上がって、解決できます。そうすると、あとはアクチュエーターの性能なども問題になってくるので、去年から今年にかけてのバージョンアップのようなものが出てきた、ということだと思います。
そこから一歩先で、今難しいと思われるのは、物とのインタラクションですね。シミュレーション上でデータを収集しようとした場合、物をつかんだりするときには、見え方だけではなく物理的な特性まですべて再現しなければいけないんですが、なかなかうまくいかない。なので、人が動き方を直接指示してデータを集めるのが一般的です。一方で、ワールドモデルなどの技術を用いて人間が定義しなくても世界をシミュレーションしてくれる、という方針もあります。結局のところ、人間が解ききれない世の中の複雑さに対して、どうデータで勝負するか。そこが今のネックになっているポイントだと思っています。
具体的には、たくさん人を集めてひたすらデータを取り、それを学習データにして精度を上げていく方針が多く取られています。一方で、いろいろな会社さんが面白いアプローチをしています。例えばエゴセントリックといって、頭にカメラを付けて人間の手の動きを大量に学習させ、それを事前学習モデルとして使ってみたら、ChatGPTのような、すごく精度のいいモデルができました、という話もあります。
坂本:
なるほど。
藤本:
ただ、私が思うのは、どちらも結局、精度は上がるけれど100%にはならないんですよね。なので、ここをどうやったら打破できるかが、一番重要な論点だと思っています。
そこで重要なのは、ある意味、もう現場にロボットを入れてしまうことだと思うんです。もちろん安全対策は重要で、失敗しそうなときは人が止める、というプロセスにして、本番にどんどん導入していく。そうすれば、データも集まってくるし、改善ループが回る。いち早く本番に導入して、実際に問題を解決しようという会社さんが、今後強くなっていくと思います。
坂本:
現場に置いて学習させるのが有効だと思う一方で、物理的なものであるがゆえに、AIエージェントとは違う形でリスクをコントロールしなければいけない部分もあると思うのですが、そのあたりはどうですか?
藤本:
まさにその通りです。物流や家庭用ロボットでも、作業内容や利用環境によってリスクは異なります。作業が完了しないことと、人に危害が及ぶことを分けて考え、安全を確認しながら導入範囲を広げる必要があります。そのうえで当面は、失敗したら大事故になるところではなく、対象業務を限定でき、作業に失敗した場合の影響を小さく抑えられる用途からスタートすると思います。最近は、階段を上る掃除ロボットのようなものも出てきましたが、まさに、そういったところからスタートするだろうと思っています。
坂本:
階段を上る掃除ロボットって出たんですか?
藤本:
この間のCES、1月ぐらいに行ったら出ていましたね。
坂本:
AIエージェントの世界では、タスクを細かく切り、いくつかの代表的なスーパーエージェントから各エージェントにタスクを振る形が望ましいのかなと思っています。バーチャルの世界なら、エージェント同士をマルチに連携させることが無数にできる。物理的なロボットでも、そういう連携は起きていくんでしょうか?
藤本:
それは全然起こり得ると思います。まずLLMの世界においては、マルチエージェントは昔から結構言われていました。ただ、例えば3年ぐらい前のAIは、プロンプトエンジニアリングが重要と言われていた時は、例えば、小説家のプロンプトを入れた小説家エージェントと、編集エージェントをぐるぐる回して精度を上げましょう、という話がありました。でも、あれは結局、エージェントの性能が低いから専用のプロンプトを入れる必要があったんです。エージェントの性能が上がれば、「自分でやってよ」という感じで、2人分の役割を勝手に考えてもらえればうまくいく。
坂本:
つまり、役割分担させる必要がなくなる、ということですね。
藤本:
もちろん、色々解かせたいタスクがある中で別のタスクに振り分けるとか、タスクごとに要求されるエージェントの権限の問題もあるので一概には言えないですけど、理想的には、1つのすごく頭のいいエージェントが全部できればいい、というのが仮想の世界では成り立つ。なので、マルチエージェントではなく、すごく頭のいいシングルエージェントを1つ使う、というのが1つの解決策ではあります。もちろん、コストの問題で特定の領域のモデルを使う、ということもありますが。
一方、物理世界に関しては、1つのものが全部やるというのは当然不可能です。ロボットは機体ごとに、持てる物の重さや速さ、場所が違ったりするので、一つ一つに仕事を振り分けなければいけない、というところは当然ながら残ります。
坂本:
ロボティクスやフィジカルAIの世界でも、ハーネスという概念は同じなんでしょうか?
藤本:
フィジカルAIのハーネスについて、ちょっと余談ですが、ヒューマノイドロボットを展示するとき、後ろから上に吊るすんですが、あれをハーネスと呼んだりしますよね(笑)。ああいったハーネスもあります。同じものとは一概には言えないですが、安全のための仕組みという点では共通するものはあると思います。
坂本:
AIエージェントの世界でのハーネスのような位置づけのものが、フィジカルになると、より重要になる?
藤本:
なりますね。AIエージェントが安全に働けるようにするガードレールの部分は、ロボティクスでもやっぱりどうしても必要です。接触時の衝撃を抑える機能や、危険を検知して停止する機能など、人が介入できる運用も含めて、ロボットを安全に動かすための仕組み全体を考えなければいけないと思っています。
現場にロボットを入れてしまって、失敗しそうなときは人が止める
03 / Protocol日本の現場力か、規格化か
ABEJA代表取締役CEOの岡田 陽介氏は、フィジカルAIには日本に勝ち筋があると話しています。隅々まで四角く掃く掃除のように、日本の現場には丁寧なオペレーションがある。それをデータにしてロボットに学ばせれば、強みになるという考えです。この考えを出発点に、対談は、日本の現場の丁寧さをフィジカルAIにどう生かすのか、という話へと進みました。
坂本:
日本の現場オペレーションは強いですからね、きっちりしているので。ただ、それには2つあると思っていて、製造業のようにマニュアルや形式知として大量に蓄積されている面と、掃除のように、マニュアル化されていないけれど、日本人気質の中ですごく丁寧にやっている面があります。後者は、フィジカルAIの中でどう学習させていくんですか?
藤本:
文脈に合うかわかりませんが、例えばABEJAでは、JR東日本さんとの取り組みで、お弁当をロボットに積み込む双腕ロボットを作りました。お弁当はいろいろな形状があって、質感も違う。ルールベースでお弁当を詰め込もうとすると、ケースバイケースで動かし方が違うので、データからちゃんと学習して、入れられるようにした。それによって、これまでルールベースではできなかったお弁当の詰め込みという人間の作業が、実際にできるようになった。これはすごいことだと思っています。お弁当の積み込みから配送までの流れを、ある意味マニュアルに落として、きちっとしたプロセスに落とせるからこそ、それをデータに入れられる。そういう意味で、1つ勝ち筋だという話はあると思います。
※参考:ABEJA プレスリリース(2026年9月3日)https://www.abejainc.com/news/20260903/1
ただ僕は、その強みだけで競争力が続くとは限らない、という懸念もあります。1個1個の、例えば積み込みを細かくパレタイズできることは、日本人の強みとして挙げられることもあると思うんです。ただ、それをAmazonの物流倉庫のように、荷姿や運び方を仕組みとして規格化すれば、細かな積み込みの作業自体を減らせる場合もあります。日本の現場が持つ知見を生かすことは大事ですが、今の作業を再現するだけでなく、作業全体をどう組み直すかも考える必要があります。オペレーションをしっかりやっているからフィジカルAIが入れる領域と、いわゆるAmazonの棚を運ぶロボットのように、現場のオペレーションごと変えてしまえばひっくり返ってしまう領域がある。ここはちゃんと見定めてやっていかないといけないと思っています。
坂本:
規格化してロボットに合わせたほうが効率的なら、最初からそうしたほうがいい。一方で、そうはできないものもあって、そこは現場に合わせて学習させたほうが、きめ細やかさが出る。
藤本:
そうですね。
坂本:
私は、空港でスーツケースを積み込む人たちは、ぜひ日本のグランドスタッフの方々を学習してほしいと思うんです。流れてきたスーツケースを一度止めるから、割れない。海外だと割れることもありますよね。規格化できず、なおかつ現場にきちんと落とし込まれているポイントを見極めていく、というイメージですかね。
藤本:
まさにそのようなイメージです。ただ、別の考え方もあって、スーツケースを受け取るときも、スーツケースを収納するケースのようなものを作って、その中に入れてしまえば、もう投げても大丈夫、という形にしてしまう。スーツケースを更に大きなケースに入れるところまでを仕事にしてしまえば、あとはケースを持っていくだけになる。そうすると規格化されて、最初と最後の部分だけロボティクスにしましょう、という形で、割とうまくいってしまったりする。なので、プロトコル化できる領域は結構多いと思います。
坂本:
そうですね。
藤本:
どこに行っても、現状の人間の仕事を置き換えようという話が多すぎて、先ほどのAIエージェントの話もそうなんですけど、なかなか障害が大きい。でも、規格化してしまえばできるよね、という部分は結構あるので、そういった動きも今後かなり重要になってくると思っています。
坂本:
確かに、業務をプロトコル化するという観点は、これまであまり意識されてこなかった部分かもしれません。そこを前提にしたうえで、さらに見極める、ということですね。
藤本:
そうですね。そもそも、これまでAIが何のためにあったかというと、人の代わりに自動化しましょう、というのが大きかったわけですよね。なので、みんな人が何をやっているかを考えて、それを自動化しようとする。今、自分でExcelに入力している仕事があるから、じゃあこれをAIにやらせよう、というのが一般的な考え方です。でもそうすると、次にプロトコル化できないことがネックになってくる。人がやっていることが複雑すぎるとか、細かすぎるとか。なので、全社的に根っこから変えましょう、というのが1つ重要なポイントになってきます。我々としても、現場の個別の改善を少しずつやっていくよりも、業務全体のつながりやデータ基盤までを含めて考えることがかなり重要なポイントになってきていると思っています。全社のデータをうまく扱えるようにするなど、AIを活用しやすい基盤を整えていく視点が必要です。
坂本:
一方で、プロトコル化に抵抗がある人もいると思います。現場のオペレーションの学習コストがだいぶ下がってくれば、そこまでプロトコル化を考えなくてもよくなる、ということも起きてくるんでしょうか?
藤本:
おっしゃる通りです。少量多品種に対応できるようになってきているので、AIの進化とともに、プロトコル化しなければいけない領域は、どんどん減ってきています。とはいえ、今のAI技術の能力の限界もありますし、プロトコル化すれば全体のコストが下がる、という考え方もあるので、そこは両立するポイントかなと思っています。現場ごとにプロトコルを変えるべきなのか、人間の介入を少し置いたほうがいいのかを、その場その場で考える形になってくると思います。
規格化してしまえばできるよね、という部分は結構ある
第2回では、フィジカルAIの現在地について話を聞きました。
ロボットの世界では、人がルールを組む時代から、データを与えれば問題が解ける時代へと、大きな転換が起きています。ただし、どの手法でも精度は100%にはならない。藤本氏は、ロボットを現場に入れ、失敗しそうなときは人が止めながら、本番で改善を回していく会社が強くなっていくと語りました。日本の現場のオペレーションを勝ち筋と見る考え方がある一方で、仕組みごと規格化されれば、その強みは失われるという見方も示されました。
最終回では、AIへの信頼と、人間より賢いAIの評価、そして10年後の人間の役割について、話を進めます。
← 第1回「LLMの外にある仕組みを、ハーネスと呼んでいる。」
第3回「AIと人間の関係も、人間関係と似たようなもの。」へ続く(近日公開予定) →
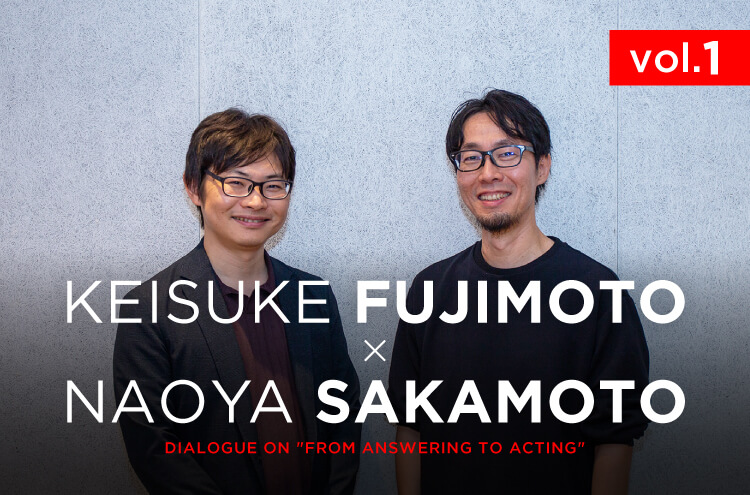
藤本 敬介 Keisuke Fujimoto
株式会社ABEJA 専門役員 先端技術研究開発担当 ラボ長/博士(工学)
2010年、電気通信大学大学院情報工学専攻博士課程修了。博士(工学)。同年、株式会社日立製作所に入社。基礎研究所および中央研究所にて、自律制御ロボット、コンピュータビジョン、3次元形状処理の研究開発に従事。2016年より株式会社 ABEJA に参画し、Labs のリサーチャーとして画像認識・自然言語処理・音声処理を応用した技術開発や新規サービスの立ち上げを担当。ビジネスとテクノロジーの両面から組織をリードしている。

坂本 尚也 Naoya Sakamoto
株式会社ウフル 取締役常務執行役員
1998年 早稲田大学教育学部 卒業、コンサルティングおよび事業会社における経営企画/事業企画を経て、アンツ・アイ・ビュー・ジャパン(BULB)に創業期より参画。ソーシャルエンタープライズ構築における、コアバリューの再構築、戦略立案に従事した後、2014年にウフルへ経営統合により参画。2020年7月当社常務執行役員、2022年9月当社取締役就任。
- Share
-
-


CONTACT
ご依頼・ご相談など、お問い合せはこちら